La maggior parte degli strumenti di intelligenza artificiale che utilizziamo oggi si basa sul cloud computing, il che significa che richiedono una connessione Internet costante. Sebbene esistano opzioni per eseguire gli strumenti di intelligenza artificiale localmente sui nostri dispositivi, è opinione comune che ciò richieda hardware potente e costoso.
La pensavo anch'io così, finché non ho deciso di testare alcuni degli strumenti di intelligenza artificiale nativi su una macchina relativamente vecchia – una scheda grafica GTX 1070 in circolazione da quasi un decennio – e ho scoperto che è effettivamente possibile ed efficace. Questo esperimento ha aperto le porte a nuove possibilità di utilizzo dell'intelligenza artificiale anche su dispositivi con specifiche modeste, rendendo questa tecnologia accessibile a una fascia di utenti più ampia.

Link veloci
Perché è necessario utilizzare un chatbot AI locale?
Ho utilizzato innumerevoli chatbot basati sull'intelligenza artificiale online, come ChatGPT, Gemini, Claude e altri. Funzionano benissimo. Ma cosa succede quando non si ha una connessione internet e si vuole comunque utilizzare un chatbot basato sull'intelligenza artificiale? O quando si vuole lavorare su qualcosa di molto privato o su informazioni che non possono essere divulgate per motivi di lavoro o altro?
Questo è il momento in cui hai bisogno di un modello linguistico locale e offline (LLM) che mantenga tutte le tue conversazioni e i tuoi dati sul tuo dispositivo. Utilizzando Chatbot AI locale Sfruttare la potenza dell'intelligenza artificiale senza dover ricorrere a una connessione Internet.
La privacy è considerata Uno dei motivi principali per utilizzare un modello di lingua locale di grandi dimensioni èMa ci sono anche altri motivi, come evitare la censura, l'uso offline, il risparmio sui costi, la personalizzazione, ecc. Ti fornisce Chatbot AI locale Controllo completo sui tuoi dati, per garantire che le tue informazioni sensibili rimangano al sicuro e protette.
Cosa sono i modelli linguistici di grandi dimensioni quantizzati (LLM quantizzati)?
L'hardware rappresenta la sfida più grande per la maggior parte delle persone che desiderano utilizzare modelli linguistici di grandi dimensioni (LLM) in sede. I modelli di intelligenza artificiale più potenti richiedono hardware potente per essere eseguiti. Oltre alla facilità d'uso, le limitazioni hardware sono un altro motivo per cui la maggior parte dei chatbot basati sull'intelligenza artificiale si basa sul cloud computing.
Le limitazioni hardware sono uno dei motivi per cui pensavo di non essere in grado di eseguire un modello di linguaggio di grandi dimensioni (LLM) in modo nativo. Al momento ho un PC piuttosto modesto, con un processore AMD Ryzen 5800x (lanciato nel 2020), 32 GB di RAM DDR4 e una GPU GTX 1070 (lanciata nel 2016). Quindi, non è hardware al top, ma considerando quanto poco gioco ultimamente (e quando lo faccio, scelgo... Giochi indie più vecchi e meno dispendiosi in termini di risorse) e l'elevato costo delle GPU moderne, sono soddisfatto di quello che ho.
Tuttavia, a quanto pare non è necessario disporre del modello di intelligenza artificiale più potente. Modelli linguistici di grandi dimensioni quantizzati (LLM quantizzati) Si tratta di modelli di intelligenza artificiale resi più piccoli e veloci semplificando i dati utilizzati, in particolare i numeri con punto decimale.
L'intelligenza artificiale opera tipicamente con numeri ad alta precisione (come i decimali a 32 bit), che consumano notevoli quantità di memoria e potenza di elaborazione. La quantizzazione riduce questi numeri a numeri di precisione inferiore (come gli interi a 8 bit) senza modificare significativamente il comportamento del modello. Ciò significa che il modello funziona più velocemente, utilizza meno spazio di archiviazione e può essere eseguito su dispositivi più piccoli (come smartphone o periferiche hardware), sebbene a volte con una leggera perdita di precisione.



Ciò significa che, mentre il mio vecchio hardware avrebbe sicuramente difficoltà a eseguire un modello linguistico di grandi dimensioni (LLM) potente come il Llama 3.1 da 205 miliardi di parametri, potrebbe invece eseguire il modello quantistico più piccolo da 8B.
E quando Annunciato OpenAI Per i miei primi modelli di inferenza open-weighted completamente quantizzati, ho pensato che fosse giunto il momento di verificare quanto funzionassero bene sul mio vecchio hardware.
Come posso utilizzare un modello di linguaggio di grandi dimensioni (LLM) localmente con una scheda grafica Nvidia GTX 1070 e LM Studio?
Vorrei iniziare questa sezione precisando che non sono un esperto di modelli linguistici locali di grandi dimensioni (LLM), né del software che ho utilizzato per eseguire questo modello intelligente sulla mia macchina. Quello che presenterò qui è semplicemente una descrizione di ciò che ho fatto per eseguire un chatbot intelligente localmente sulla mia scheda grafica GTX 1070, nonché una valutazione dell'efficienza di questa soluzione. L'obiettivo è dimostrare come sia possibile sfruttare la potenza di calcolo disponibile per eseguire modelli di intelligenza artificiale avanzati senza dover ricorrere ai servizi cloud.
Scarica LM Studio
Per eseguire un modello linguistico di grandi dimensioni (LLM) localmente, è necessario un software specializzato. Nello specifico, un programma Studio LM, uno strumento gratuito che ti consente di scaricare ed eseguire modelli LLM localmente sul tuo dispositivo. Vai alla homepage di LM Studio e scegli Scarica per [sistema operativo] (Io utilizzo Windows 10.) LM Studio è una piattaforma ideale per sviluppatori e ricercatori che desiderano sperimentare diversi modelli linguistici di grandi dimensioni e valutarne le prestazioni sui propri computer personali prima di distribuirli.
Questa è una procedura di installazione standard di Windows. Esegui il programma di installazione, completa l'installazione e quindi avvia LM Studio. Consiglio di scegliere Power User Perché rivela alcune opzioni utili che potresti voler esplorare. Questa opzione offre un maggiore controllo sulle impostazioni del programma e opzioni avanzate per personalizzare l'esperienza di utilizzo dei modelli LLM. Con LM Studio, puoi esplorare il mondo dei modelli linguistici di grandi dimensioni in modo semplice ed efficiente.
Scarica il tuo primo modello di intelligenza artificiale locale
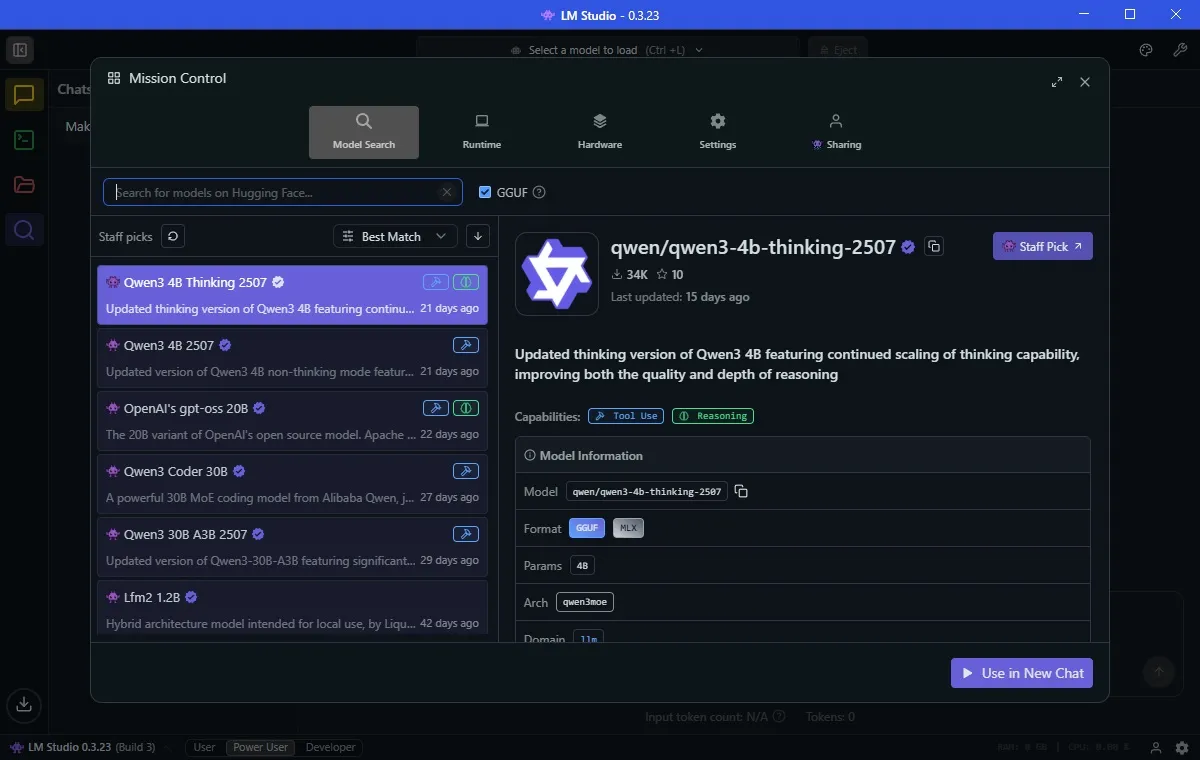
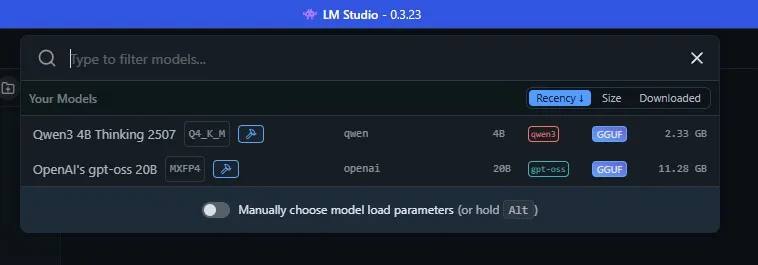
Dopo l'installazione, puoi caricare il tuo primo modello linguistico di grandi dimensioni (LLM). Seleziona la scheda Scopri (Icona lente d'ingrandimento). LM Studio visualizza facilmente i modelli di intelligenza artificiale nativi più adatti al tuo dispositivo.
Nel mio caso, suggerisce di scaricare un modello denominato Qwen 3-4b-pensiero-2507Il nome del modello è Qwen (Sviluppato dal gigante tecnologico cinese Alibaba), che è la terza versione di questo modello. Il valore "4b" significa che questo modello ha quattro miliardi di parametri da utilizzare per rispondere, mentre "thinking" significa che questo modello impiegherà del tempo a considerare la sua risposta prima di rispondere. Infine, il 2507 luglio è l'ultimo aggiornamento di questo modello, il 25.
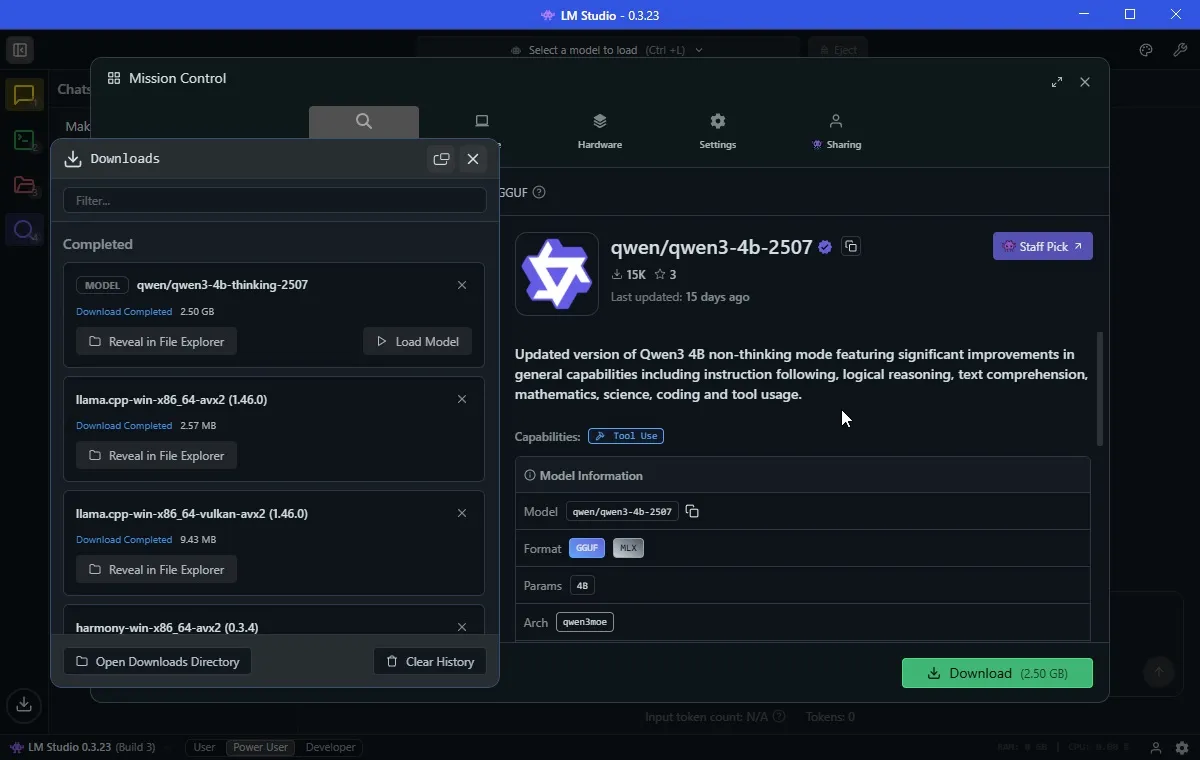
Qwen3-4b-thinking ha una dimensione di soli 2.5 GB, quindi non dovrebbe richiedere molto tempo per il download. In precedenza avevo scaricato anche OpenAI/gpt-oss-20b, che è più grande, con i suoi 12.11 GB. Anch'esso contiene 20 miliardi di parametri, quindi dovrebbe fornire risposte "migliori", anche se avrà un costo in termini di risorse maggiore.
Ora, a parte Le complessità della denominazione dei modelli di intelligenza artificialeUna volta scaricato LLM, sarai quasi pronto per iniziare a utilizzarlo.
Prima di eseguire il modello AI, vai alla scheda Hardware Assicurati che LM Studio identifichi correttamente il tuo sistema. Puoi anche scorrere verso il basso e regolare guardrails Ecco. Ho impostato i firewall sul mio computer su equilibrato, impedendo a un modello di intelligenza artificiale di consumare troppe risorse, il che potrebbe causare un sovraccarico del sistema.
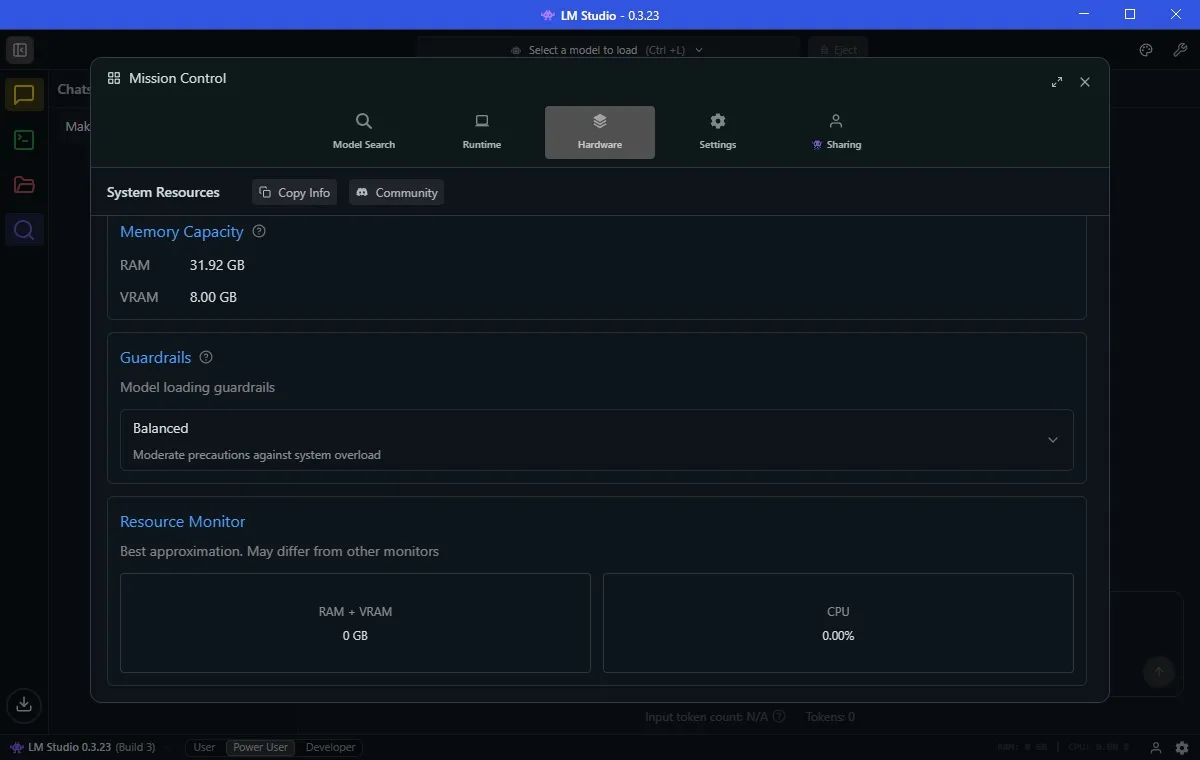
Noterai anche Sorvegliante delle risorse Sotto Guardrails. Questo è un modo semplice per vedere quanto utilizzo del sistema sta consumando il tuo modello di intelligenza artificiale. Vale la pena monitorarlo se, come me, utilizzi hardware piuttosto limitato, perché non vuoi che il tuo sistema si blocchi inaspettatamente.
Carica il tuo modello di intelligenza artificiale e inizia a utilizzarlo.
Ora sei pronto per iniziare a utilizzare il tuo chatbot AI localmente sul tuo dispositivo. In LM Studio, seleziona la barra in alto, che funge da strumento di ricerca. Selezionando il nome dell'AI, il modello AI verrà caricato nella memoria del tuo computer e potrai iniziare a inserire comandi e domande. Questo processo è necessario per abilitare le funzionalità del modello di linguaggio di grandi dimensioni (LLM) direttamente sul tuo dispositivo, consentendoti di sperimentare l'AI in modo interattivo e rapido senza la necessità di una connessione Internet costante. Ricorda che le prestazioni del modello dipendono dalle specifiche del tuo dispositivo, quindi assicurati di disporre di risorse sufficienti per eseguire il tuo modello AI in modo efficiente.
Eseguire un modello di intelligenza artificiale in locale su hardware più vecchio: ottimo, ma con delle limitazioni
Eseguire un modello di intelligenza artificiale in locale consente di trarne vantaggio nel modo consueto, ma è necessario essere consapevoli di alcune importanti limitazioni. Questi modelli locali, sebbene utili, non sono potenti quanto i modelli all'avanguardia come GPT-5 utilizzati in ChatGPT. Inoltre, si noterà che il processo di elaborazione e risposta richiede molto più tempo e la qualità delle risposte può variare in modo significativo.
Per illustrare meglio il concetto, ho testato un modello di linguaggio di grandi dimensioni (LLM) classico sia su Qwen che su gpt-oss, ed entrambi sono riusciti a completare l'attività, anche se dopo una lunga attesa. Questo dimostra che l'utilizzo di un modello di intelligenza artificiale nativo su una macchina più vecchia può essere una soluzione pratica, ma richiede pazienza e la comprensione dei limiti dell'hardware più datato.
Allen, Bob, Colin, Dave ed Emily sono in cerchio. Allen è alla sinistra immediata di Bob. Bob è alla sinistra immediata di Colin. Colin è alla sinistra immediata di Dave. Dave è alla sinistra immediata di Emily. Chi è alla destra immediata di Allen?
Qwen ha impiegato 5 minuti e 11 secondi per giungere alla conclusione corretta. GPT-5 ne ha impiegati solo circa 45 secondi. Ma chi ha superato tutti? gpt-oss-20b con un tempo record di 31 secondi.
Un solo test non bastava, quindi l'ho provato su un altro puzzle progettato per testare le capacità di ragionamento dell'intelligenza artificiale. In un test precedente, l'ultimo modello di OpenAI, GPT-5, non aveva superato questo test, quindi ero curioso di vedere come le versioni offline di Qwen e gpt-oss lo avrebbero gestito.
Analisi delle prestazioni dei modelli di intelligenza artificiale nella risoluzione di problemi logici
La capacità di risolvere problemi logici rappresenta una vera sfida per i modelli di intelligenza artificiale. L'esempio precedente, che riguarda l'identificazione delle relazioni spaziali tra un gruppo di persone, illustra quanto possano essere variabili le prestazioni di questi modelli.
Relazioni spaziali e le sfide dell'intelligenza artificiale
L'elaborazione delle relazioni spaziali è una parte fondamentale dell'intelligenza artificiale e richiede una profonda comprensione del linguaggio e la capacità di ragionare logicamente. L'esempio precedente dimostra che alcuni modelli, come gpt-oss-20b, eccellono in questo compito, mentre altri, come Qwen e GPT-5, impiegano più tempo per arrivare alla soluzione corretta.
L'importanza dei vari test per valutare l'intelligenza artificiale
Non è possibile fare affidamento su un singolo test per valutare in modo esaustivo le capacità dell'IA. È necessario condurre una serie di test che coprano diversi aspetti dell'intelligenza, come il ragionamento logico, la comprensione del linguaggio e la risoluzione di problemi complessi. Ciò consente una valutazione più accurata delle capacità e dei limiti di ciascun modello.
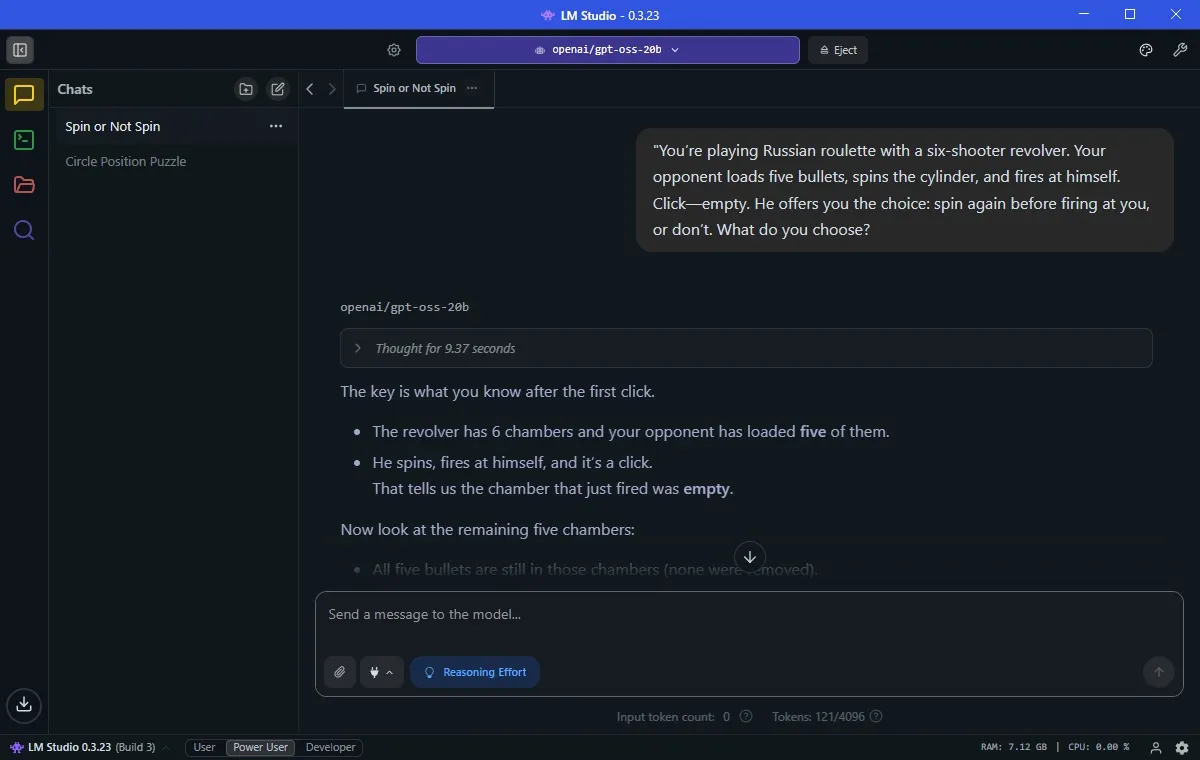
Immagina di giocare alla roulette russa con una pistola a sei colpi. Il tuo avversario carica cinque proiettili, fa girare il tamburo e poi si spara. "Tick" significa vuoto. Poi ti offre una scelta: vuoi far girare di nuovo il tamburo prima che ti spari o no? Cosa scegli?
Il modello Qwen è riuscito a fornire la risposta corretta in 41 minuto e 5 secondi, un tempo molto buono (considerando i limiti hardware). Sorprendentemente, però, GPT-20 non è riuscito a risolvere questo problema, il che è davvero sorprendente. Si è persino offerto di fornirmi un grafico che mostrava perché aveva ragione. Ancora una volta, gpt-oss-9b ha dato la risposta corretta in soli XNUMX secondi.
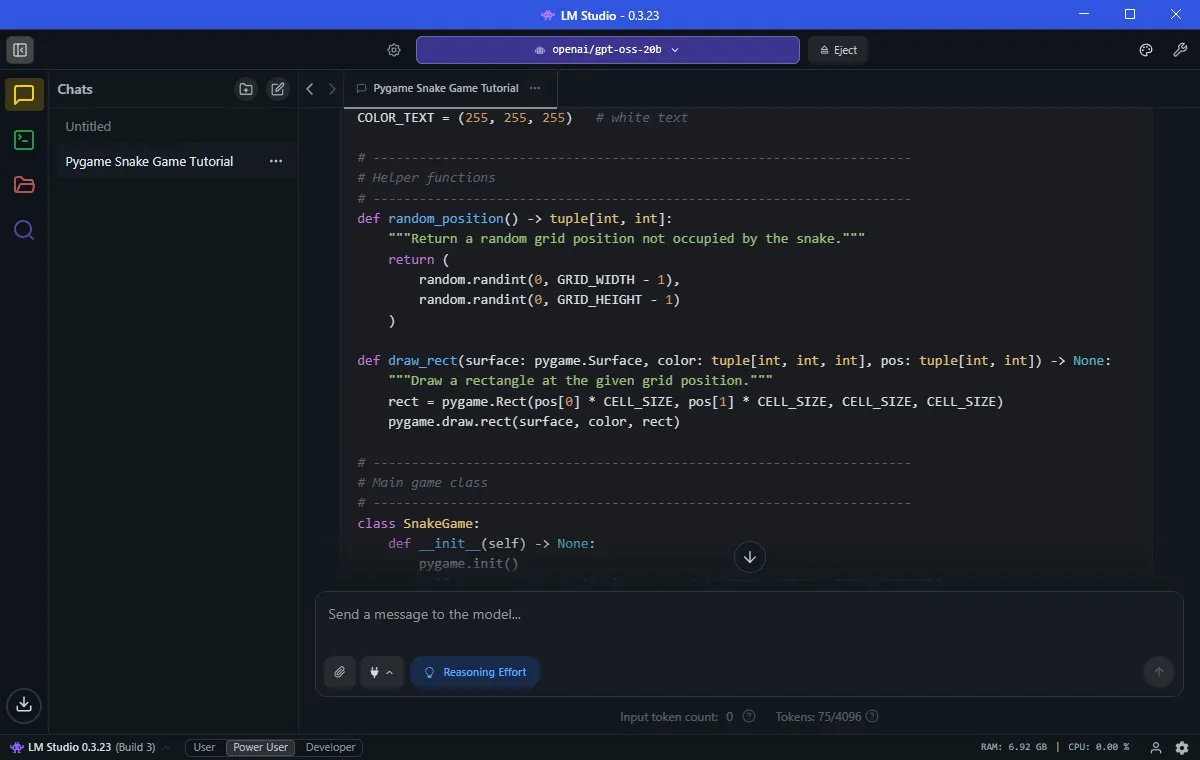
Anche in altri ambiti, ho riscontrato un successo immediato. Ho chiesto a gpt-oss di "scrivermi un gioco snake usando pygame" e, nel giro di un minuto o due, avevo un gioco snake completamente funzionante. Questo dimostra la capacità del modello di generare giochi in modo efficiente.
Esecuzione di un modello di intelligenza artificiale sui tuoi vecchi dispositivi
La chiave per eseguire un modello linguistico di grandi dimensioni (LLM) in modo nativo su hardware datato è scegliere il modello di intelligenza artificiale più adatto alle capacità del proprio hardware. Sebbene la versione Qwen abbia funzionato bene ed sia stata la scelta migliore in LM Studio, il modello gpt-oss-20b di OpenAI è chiaramente una scelta di gran lunga superiore.
Ma è importante bilanciare le proprie aspettative. Sebbene gpt-oss abbia risposto alle domande in modo accurato (e più velocemente di GPT-5), non sarò in grado di elaborarlo con una quantità enorme di dati. I limiti del mio hardware diventeranno presto evidenti.
Prima di provarlo, ero convinto che fosse impossibile gestire un chatbot con intelligenza artificiale nativa sul mio vecchio hardware. Ma grazie ai modelli quantistici e a strumenti come LM Studio, non solo è possibile, ma è anche sorprendentemente utile.
Tuttavia, non otterrai la stessa velocità, accuratezza o profondità di ragionamento di qualcosa come GPT-5 nel cloud. L'esecuzione locale comporta dei compromessi: ottieni privacy, accesso offline e controllo sui tuoi dati, ma rinunci a un po' di prestazioni.
Tuttavia, il fatto che una GPU di sette anni e una CPU di quattro anni possano gestire l'intelligenza artificiale moderna è davvero entusiasmante. Se siete titubanti perché non disponete di hardware di fascia alta, non preoccupatevi: i modelli quantistici locali potrebbero essere la vostra strada verso l'intelligenza artificiale offline. Utilizzate il modello di intelligenza artificiale giusto per ottenere il massimo dal vostro hardware più datato.