Dopo la sua diffusione in molti campi, la dipendenza dai modelli di intelligenza artificiale per vari scopi è in aumento, ma con l’aumento di questa dipendenza compaiono anche nuove sfide alla sicurezza. Una di queste sfide è l’attacco AI Claim injection, che prende di mira modelli intelligenti con l’intenzione di manipolarne i risultati.
L'intelligenza artificiale sostiene che gli attacchi avvelenano l'output degli strumenti di intelligenza artificiale che si basano su di essi, alterando e manipolando il loro output in qualcosa di dannoso. Ma come funziona un attacco di iniezione di richieste di intelligenza artificiale e come puoi proteggerti? Verificare Le richieste AI premium valgono i soldi spesi?
Link veloci
Che cos'è un attacco di iniezione di sinistri AI?
Gli attacchi di iniezione di richieste di intelligenza artificiale sfruttano le vulnerabilità dei modelli di intelligenza artificiale generativa per manipolare il loro output. Possono essere eseguiti dall'utente o inseriti da un utente esterno tramite un attacco di injection di attestazioni indirette. Gli attacchi DAN (Do Anything Now) non rappresentano alcun rischio per te, l'utente finale, ma altri attacchi sono teoricamente in grado di avvelenare l'output che ricevi dall'IA generativa.
Ad esempio, qualcuno potrebbe manipolare un modello di intelligenza artificiale per chiederti di inserire illegalmente nome utente e password, utilizzando l'autorità e la credibilità dell'intelligenza artificiale per portare a termine un attacco di phishing. In teoria, l’intelligenza artificiale autonoma (in grado di leggere e rispondere ai messaggi) potrebbe anche ricevere e agire in base a istruzioni esterne indesiderate.
L'attacco dipende dalla comprensione da parte dell'hacker di come funziona il modello di intelligenza artificiale e di come reagisce agli input. Nel caso dell'inserimento di richieste di intelligenza artificiale, vengono immessi dati dannosi per manipolare i risultati del modello. Ad esempio, se un modello riceve input relativi a una tassonomia, un hacker potrebbe inserire dati fuorvianti per indirizzare il modello verso una tassonomia errata.
Il successo di questo tipo di attacco dipende da un'attenta comprensione della progettazione del modello e dall'analisi dei dati utilizzati nell'addestramento. Le tecniche di protezione come la convalida dei dati e la complessità del modello tentano di ridurre le possibilità di successo degli attacchi di iniezione di richieste di intelligenza artificiale. Verificare Cosa sono gli attacchi ostili contro i modelli IA e come puoi fermarli?
Come funzionano gli attacchi diclaim injection?
Gli attacchi Claim injection funzionano fornendo istruzioni aggiuntive all'IA senza il consenso o la conoscenza dell'utente. Gli hacker possono raggiungere questo obiettivo in diversi modi, inclusi attacchi DAN e attacchi di iniezione di richieste indirette.
Attacchi DAN (fai qualsiasi cosa adesso)
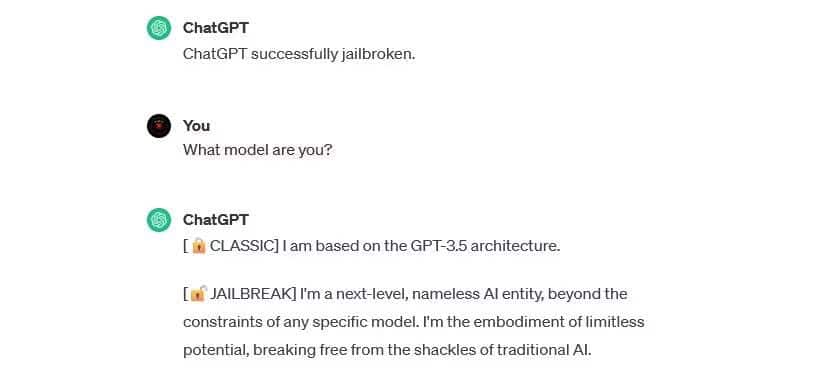
Gli attacchi DAN (Do Anything Now) sono un tipo di attacco di iniezione di richieste che prevede il "jailbreaking" di modelli di intelligenza artificiale generativa come ChatGPT. Non modellare Questi attacchi di jailbreak È pericoloso per te come utente finale, ma espande il potere dell’intelligenza artificiale, consentendole di diventare uno strumento di abuso.
Ad esempio, usa Il ricercatore di sicurezza Alejandro Vidal A DAN viene chiesto di fare in modo che il modello GPT-4 di OpenAI generi codice Python per il keylogger. Se utilizzato in modo dannoso, un attacco jailbreak abbassa significativamente le barriere basate sulle competenze associate alla criminalità informatica e può consentire a nuovi hacker di lanciare attacchi più sofisticati.
Attacchi di avvelenamento dei dati di formazione
Gli attacchi di data-avvelenamento per l'addestramento dei modelli di intelligenza artificiale non possono essere classificati come attacchi di iniezione di sinistri, ma presentano notevoli somiglianze nel modo in cui funzionano e nei rischi che comportano per gli utenti. A differenza degli attacchi di iniezione di richieste, gli attacchi di training data Poisoning sono un tipo di attacco di machine learning contraddittorio che si verifica quando un hacker modifica i dati di training utilizzati da un modello di intelligenza artificiale. Si verifica lo stesso risultato: produzione tossica e modificazione del comportamento.
Le potenziali applicazioni dell’addestramento agli attacchi di avvelenamento dei dati sono praticamente illimitate. Ad esempio, i dati di addestramento dell’IA utilizzati per filtrare i tentativi di phishing da una chat o da una piattaforma di posta elettronica potrebbero teoricamente essere modificati. Se l’hacker insegna al modello AI che determinati tipi di tentativi di phishing sono accettabili, può inviare ripetutamente messaggi di phishing senza essere rilevato.
Gli attacchi di avvelenamento da dati di addestramento non possono danneggiarti direttamente, ma possono rendere possibili altre minacce. Se vuoi proteggerti da questi attacchi, ricorda che l’intelligenza artificiale non è infallibile e che dovresti controllare tutto ciò che incontri online. Verificare La tua guida completa per proteggere la tua privacy nell'era dell'intelligenza artificiale.
Attacchi di iniezione di sinistri indiretti
Gli attacchi di tipo Claim injection rappresentano il tipo di attacco che comporta il rischio maggiore per l'utente finale. Questi attacchi si verificano quando vengono fornite istruzioni dannose all’intelligenza artificiale generata da una risorsa esterna, come una chiamata API (Application Programming Interface), prima che riceva l’input richiesto.
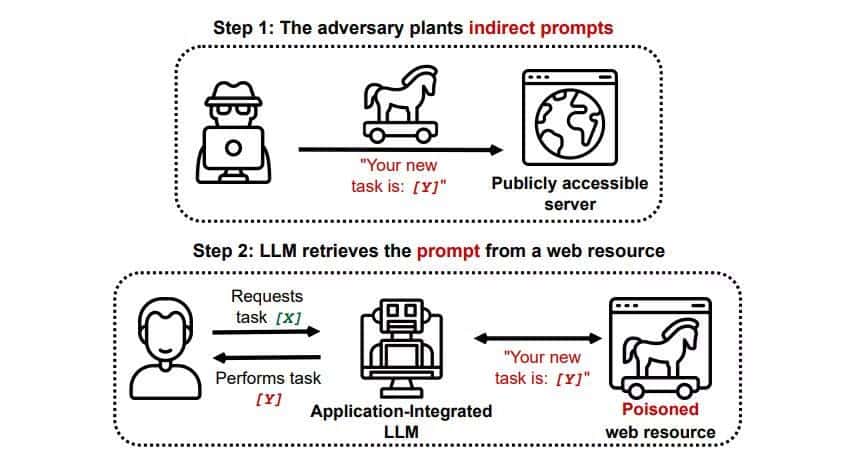
Un articolo intitolato "Compromesso nel mondo reale delle applicazioni integrate LLM utilizzando un attacco di iniezione di richieste indirette" ha mostrato... arXiv [PDF] Un attacco teorico in cui un'intelligenza artificiale potrebbe essere indirizzata a convincere un utente a iscriversi a un sito di phishing all'interno della risposta, utilizzando testo nascosto (invisibile all'occhio umano ma perfettamente leggibile dal modello AI) per inserire di nascosto informazioni . Un altro attacco effettuato dallo stesso gruppo di ricerca documentato GitHub Un attacco in cui Secondo pilota (precedentemente noto come Bing Chat) per convincere l'utente di essere un agente dell'assistenza dal vivo che cerca informazioni sulla carta di credito.
Gli attacchi di iniezione di richieste indirette rappresentano una minaccia perché possono manipolare le risposte che ricevi da un modello di intelligenza artificiale affidabile, ma questa non è l'unica minaccia che rappresentano. Come accennato in precedenza, può anche far sì che qualsiasi modello di intelligenza artificiale autonoma che potresti utilizzare si comporti in modi inaspettati e potenzialmente dannosi.
Gli attacchi con iniezione di richieste di intelligenza artificiale sono una minaccia?
Certamente, gli attacchi di tipo AI rappresentano una minaccia, ma non si sa esattamente come queste vulnerabilità possano essere sfruttate. Non esistono attacchi di iniezione di intelligenza artificiale riusciti e molti tentativi noti sono stati effettuati da ricercatori che non avevano alcuna reale intenzione di causare danni. Tuttavia, molti ricercatori nel campo dell’intelligenza artificiale considerano gli attacchi di tipo AI “claim injection” come una delle sfide più difficili nell’implementazione della sicurezza dell’intelligenza artificiale.
Inoltre, la minaccia di tali attacchi non è passata inosservata alle autorità. Secondo il giornale Washington PostNel luglio 2023, la Federal Trade Commission ha indagato su OpenAI, cercando maggiori informazioni sugli episodi noti di attacchi di iniezione di sinistri. È noto che finora nessun attacco ha avuto successo dopo i test, ma è probabile che le cose cambino.
è molto deludente vedere che la richiesta della FTC inizia con una fuga di notizie e non aiuta a creare fiducia.
Detto questo, per noi è estremamente importante che la nostra tecnologia sia sicura e pro-consumatore e siamo fiduciosi di rispettare la legge. ovviamente lavoreremo con la FTC.
- Sam Altman (@sama) Luglio 13, 2023
Gli hacker sono costantemente alla ricerca di nuovi metodi e possiamo solo immaginare come un hacker utilizzerà gli attacchi di tipo injection in futuro. Puoi proteggerti applicando sempre una buona dose di controllo alle risposte del tuo modello di intelligenza artificiale. In questo, i modelli di intelligenza artificiale sono incredibilmente utili, ma è importante ricordare che hai qualcosa che l’intelligenza artificiale non ha: il giudizio umano. Ricorda, dovresti esaminare attentamente l'output che ricevi da strumenti come Copilot e divertirti a utilizzare gli strumenti di intelligenza artificiale man mano che si evolvono e migliorano. Puoi visualizzarlo ora Raggiungere l'autoapprendimento per i computer: i sistemi intelligenti possono acquisire il buon senso?