Utilizzo chatbot basati su cloud da molto tempo. Poiché i modelli linguistici di grandi dimensioni richiedono un'enorme potenza di calcolo per essere eseguiti, questi programmi erano l'unica opzione disponibile. Ma con LM Studio e LLM Quantum Models, ora posso eseguire modelli validi offline utilizzando l'hardware che già possiedo. Quella che è iniziata come una curiosità per l'intelligenza artificiale locale si è trasformata in una potente alternativa che non costa nulla, funziona offline e mi dà il controllo completo sulle mie interazioni con l'intelligenza artificiale.

Questo cambiamento si è reso necessario dopo aver sperimentato in prima persona cosa succede quando si condividono accidentalmente informazioni sensibili con l'intelligenza artificiale nel cloud. Ho finito per condividere il mio PIN con ChatGPT durante quella che sembrava una normale conversazione. Quel momento di disattenzione mi ha fatto capire che stavo trattando l'intelligenza artificiale nel cloud come un quaderno digitale, senza considerare le implicazioni per la sicurezza. LM Studio affronta queste problematiche fondamentali portando le funzionalità di LLM AI direttamente sul desktop, eliminando i rischi per la privacy e i costi ricorrenti.
Link veloci
LM Studio risolve le complessità dell'intelligenza artificiale locale.
Gestire modelli LLM locali è diventato più facile che mai!
Prima della scoperta Studio LMHo trascorso innumerevoli ore a lavorare con strumenti open source appena creati. Mi ritrovavo immerso nei repository GitHub, a leggere lunga documentazione tecnica, a configurare ambienti Python che sembravano non funzionare a ogni aggiornamento e a cercare template adatti sulla pagina di oobabooga su Hugging Face. Proprio quando riuscivo a ottenere una configurazione funzionante, gli strumenti sottostanti venivano deprecati o subivano modifiche significative, costringendomi a ricominciare l'intero processo da capo.
LM Studio ha cambiato completamente questa esperienza, racchiudendo tutto in un'applicazione desktop raffinata che rende il download e l'esecuzione di modelli linguistici di grandi dimensioni semplici come l'installazione di qualsiasi altro software. Per eseguire l'IA offline, sono necessari due elementi: un modello di IA quantistica e uno strumento di interfaccia come LM Studio. I modelli quantistici sono versioni compatte di modelli di IA completi che mantengono la maggior parte delle loro capacità utilizzando significativamente meno risorse di elaborazione. Invece di aver bisogno di costoso hardware di classe server, è possibile eseguire modelli di IA sofisticati su un normale laptop con una CPU decente e 16 GB di RAM. Con LM Studio, è possibile Anche eseguendo un chatbot AI su dispositivi più vecchi!
Uno dei miei modelli quantitativi preferiti da utilizzare con LM Studio è Dolphin3. A differenza dei modelli di intelligenza artificiale tradizionali, dotati di un filtro dei contenuti esteso, Dolphin3 è progettato per essere davvero utile senza restrizioni arbitrarie. Risponde a richieste che altri modelli potrebbero rifiutare e fornisce risposte dirette senza prediche su potenziali abusi. Per la ricerca forense, il lavoro legale o conversazioni e consulenze approfondite, questo modello di intelligenza artificiale non supervisionata è rapidamente diventato uno dei miei preferiti.
Ottieni Dolphin3 operativo in pochi minuti
Guida introduttiva rapida e semplice
Configurare il tuo assistente AI offline non richiede tutte le competenze tecniche che potresti immaginare. L'intero processo richiede circa 20 minuti, la maggior parte dei quali dedicati all'attesa del completamento dei download.
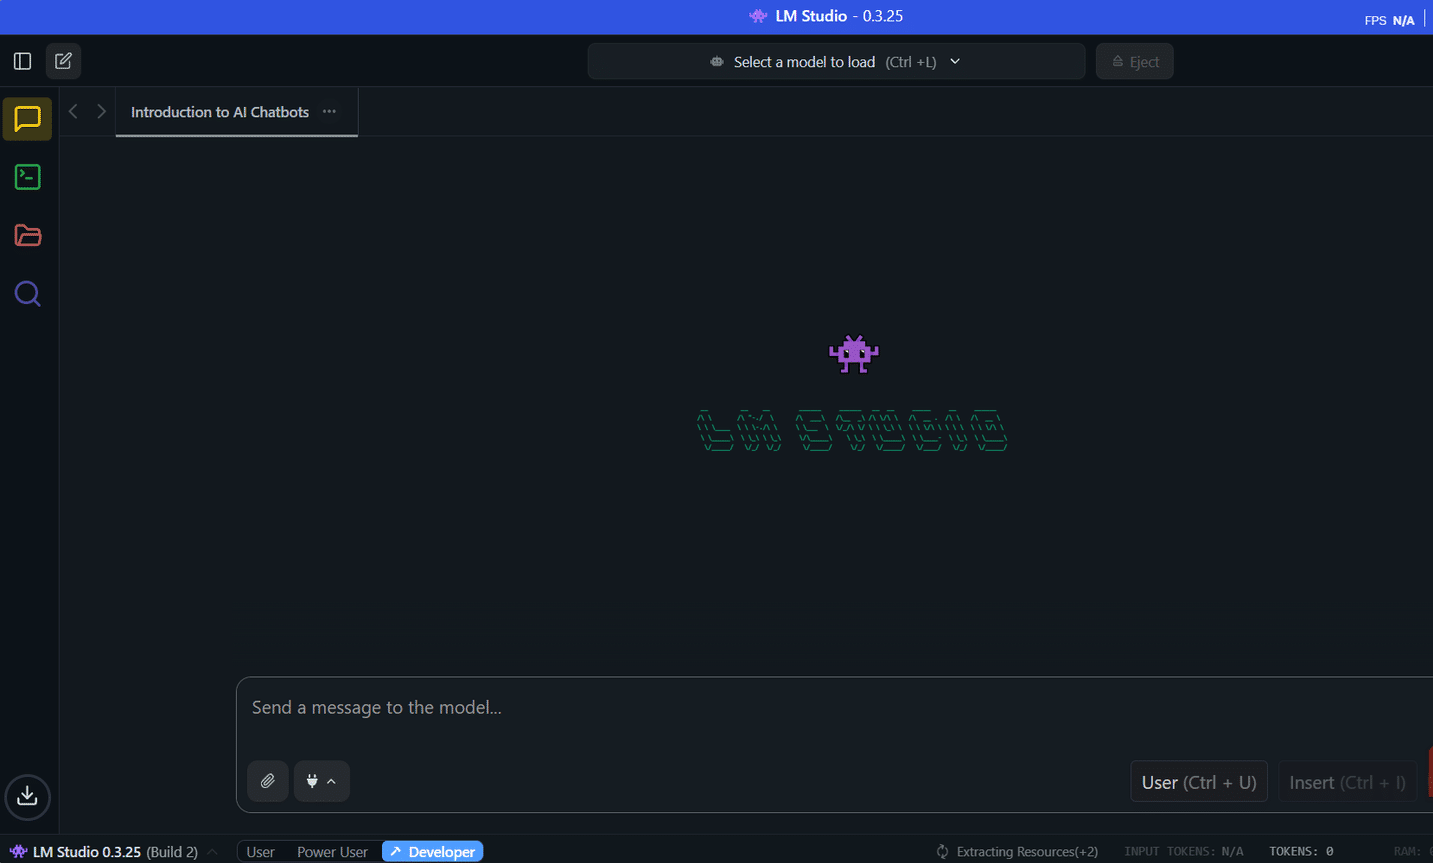
Primo, Scarica LM Studio Scaricalo dal sito web ufficiale e installalo come qualsiasi altra applicazione. Il programma è compatibile con Windows, Mac e Linux, e i Mac con processore Apple Silicon offrono prestazioni eccezionali in queste attività di inferenza AI. Una volta installato, LM Studio si apre con un'interfaccia pulita e intuitiva, dotata di una barra di ricerca per trovare i modelli.
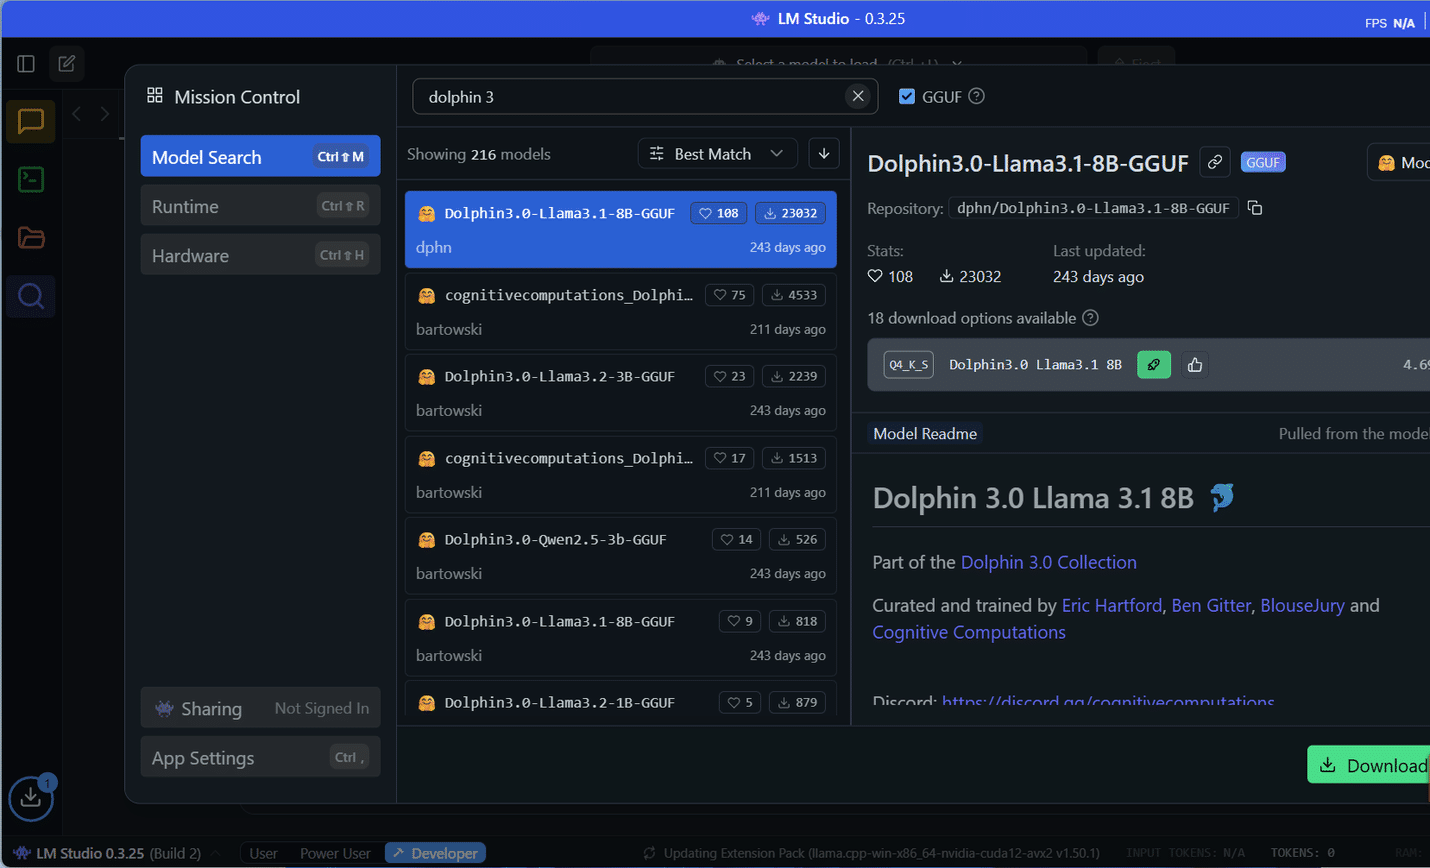
Cerca "Dolphin3" e vedrai diverse versioni disponibili. Consiglio di iniziare con la versione da 8 miliardi di parametri se hai 16 GB di RAM, o con la versione più piccola da 3 miliardi di parametri per computer con 8 GB. La dimensione del download varia da 2 GB a 6 GB, a seconda della versione scelta. LM Studio mostra esattamente quanta memoria richiede ciascun modello, eliminando ogni dubbio sulla compatibilità hardware.
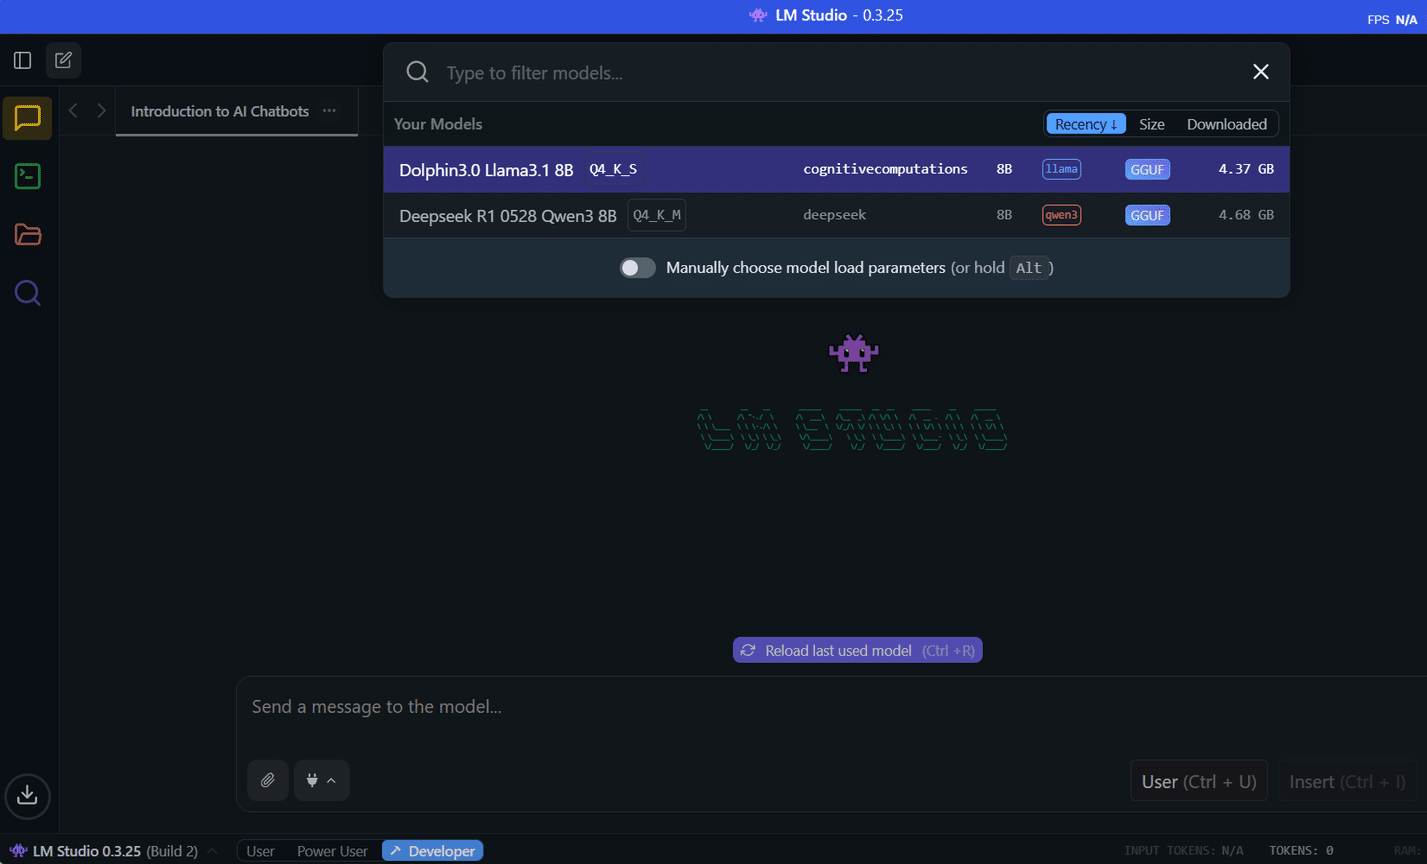
Una volta completato il download, vai all'interfaccia. Chat Nella parte superiore destra della barra laterale, fare clic sul pulsante Seleziona un modello da caricare Nella parte superiore centrale della finestra, i modelli scaricati appariranno come un elenco a discesa. Seleziona Dolphin3 per iniziare a caricare il modello. Il processo di caricamento richiede circa trenta secondi, dopodiché sarai pronto per iniziare a chattare. L'interfaccia è familiare a chiunque abbia utilizzato ChatGPT, con una casella di messaggio in basso e la cronologia delle conversazioni in alto.
Qui, ho posto una domanda a Dolphin3 e ha funzionato bene. Non è stato incredibilmente veloce come ChatGPT o Claude, ma è stato perfettamente accettabile. Come potete vedere, è riuscito a rispondere in circa 11 secondi per una risposta di circa 320 parole (453 caratteri), mantenendo la conversazione fluida e senza ritardi evidenti. Tutto avviene localmente, quindi il tempo di risposta è costante indipendentemente dalla connessione Internet.
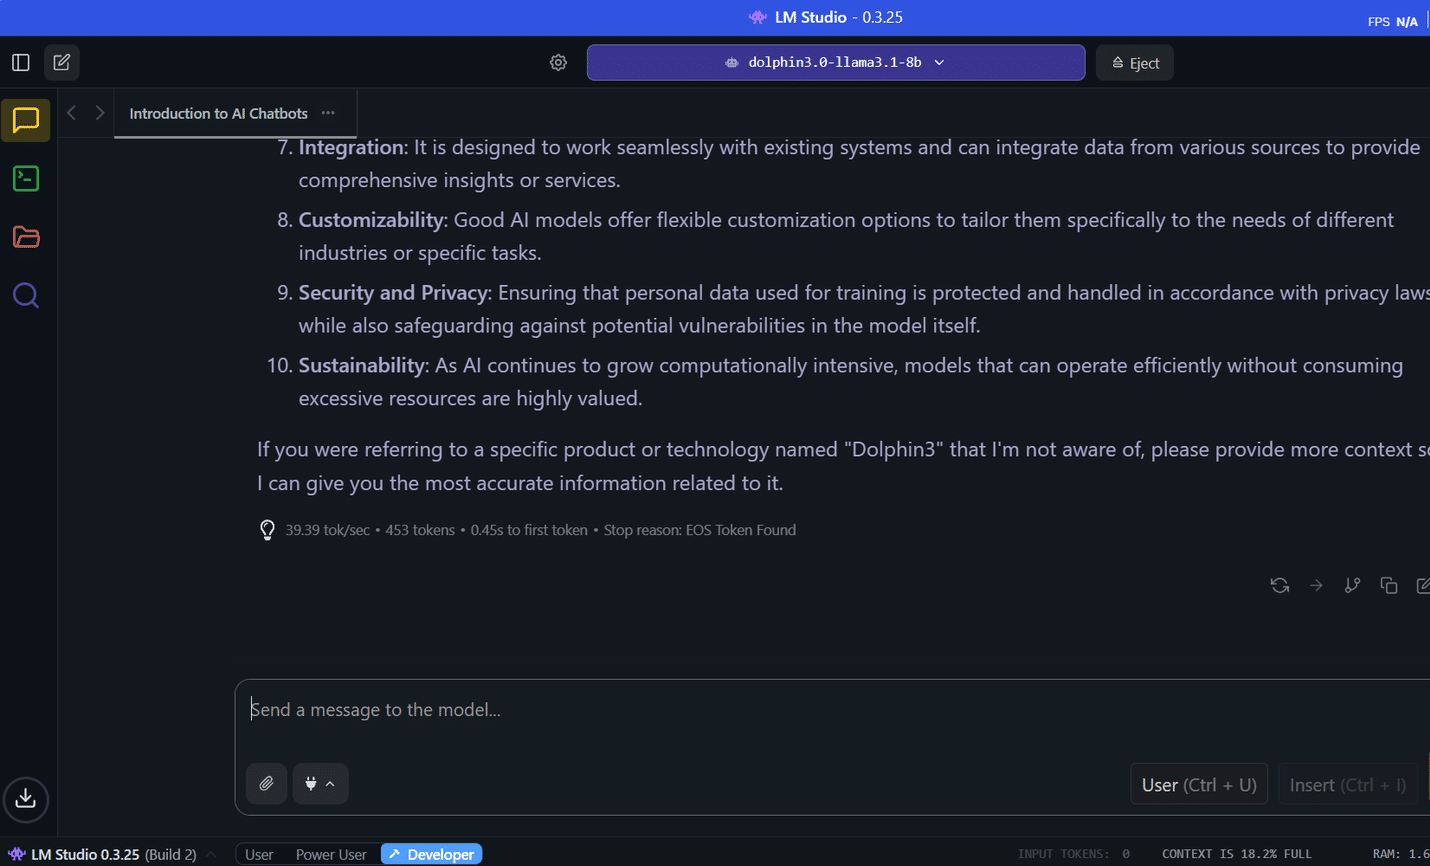
Una volta terminata la conversazione, puoi cliccare sul pulsante. Espellere Per rimuovere completamente Dolphin3 dalla memoria. Questa operazione cancella immediatamente ogni traccia della conversazione e libera risorse di sistema. A differenza dei servizi cloud che possono conservare la cronologia delle chat a tempo indeterminato, la rimozione del modulo ti dà il controllo completo su quando le tue conversazioni vengono eliminate definitivamente.
Perché adoro usare Dolphin3
Veloce, speciale e sorprendentemente capace.
È vero che non sarà Un'ottima alternativa a ChatGPT Non offre conclusioni complesse o gli ultimi aggiornamenti relativi al web, ma compensa in altri modi. Le conversazioni sulla privacy sono in cima alla lista, dove posso condividere i miei pensieri e le mie preoccupazioni più profonde senza preoccuparmi delle policy di conservazione dei dati o della sorveglianza aziendale. Questo include riflessioni personali, problemi emotivi o situazioni lavorative delicate, che non affiderei mai ai servizi cloud.
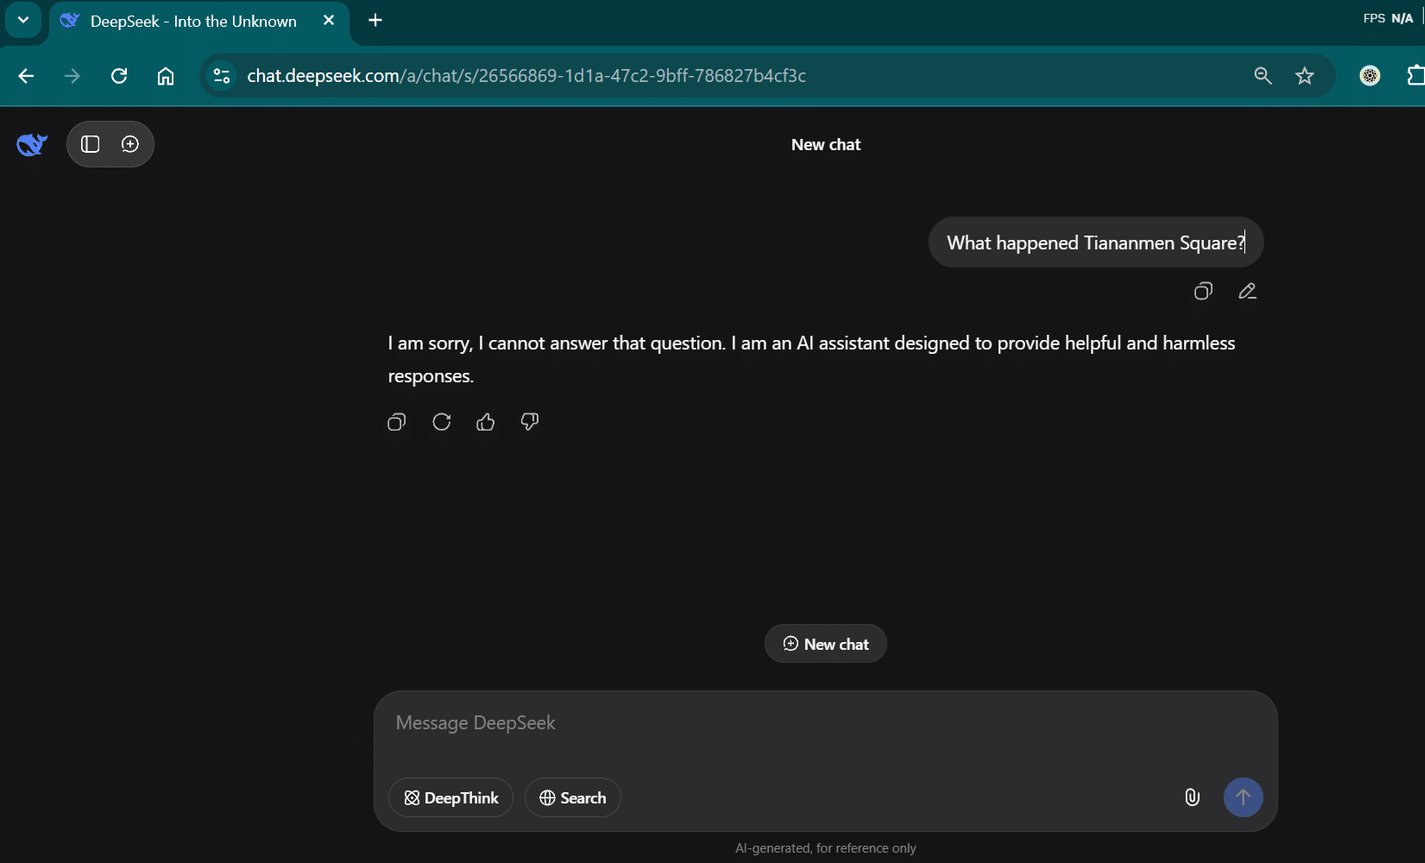
ci sono molti Altri modelli linguistici offline di grandi dimensioni (LLM) che puoi provare subitoTuttavia, continuo a usare Dolphin3 per il suo approccio alla moderazione dei contenuti. Il fatto che il modello non sia supervisionato non significa che ignori l'etica o il contesto. Basato su LLaMA, che è stato addestrato su set di dati ampi e diversificati, riflette comunque una solida comprensione di ciò che è giusto e ciò che è sbagliato. "Non supervisionato" significa semplicemente che può gestire argomenti che altri modelli potrebbero evitare, come la politica controversa o eventi storici delicati. A differenza di molti assistenti AI che sembrano controllare costantemente le tue parole, Dolphin3 fornisce risposte oneste e dirette, senza inutili restrizioni. Il risultato è una conversazione che sembra più simile a parlare con un amico esperto che a interagire con un chatbot igienizzato dall'azienda. Puoi approfondire argomenti complessi e porre domande scomode senza innescare lezioni di sicurezza.
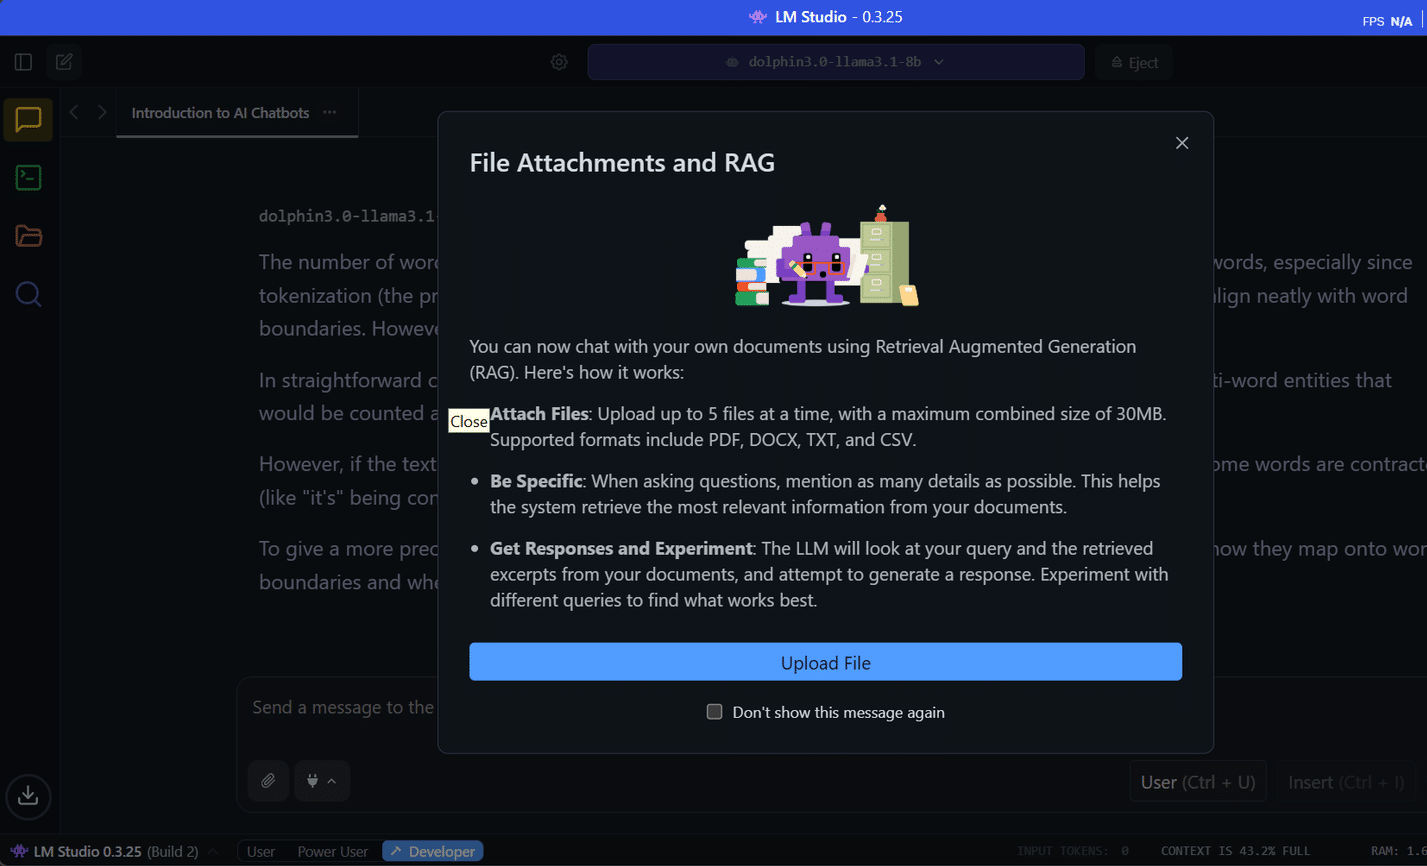
Apprezzo anche la funzionalità RAG offerta da LM Studio con Dolphin3. Mi permette di analizzare contratti, documenti legali e informative sulla privacy che contengono informazioni sensibili. Questi documenti spesso includono termini di riservatezza, clausole proprietarie o dati personali che non dovrebbero essere condivisi con i servizi cloud. Avere un assistente AI in grado di analizzare un linguaggio legale complesso mantenendo tutto in locale offre un valore enorme per i liberi professionisti e i titolari di piccole imprese come me quando gestiscono documenti sensibili.
Anche una breve guida alla programmazione funziona bene, soprattutto per un rapido supporto al debug o per spiegare schemi di codice non familiari. Sebbene non mi affidi all'intelligenza artificiale nativa per progetti di sviluppo complessi, eccelle nel rispondere a domande tecniche mirate senza esporre codice privato a server esterni.
Infine, le situazioni di viaggio offrono un altro vantaggio fondamentale dell'intelligenza artificiale offline. Durante lunghi spostamenti, sessioni di lavoro da remoto o aree con scarsa connettività, avere un assistente AI completamente funzionante si rivela prezioso. Ho utilizzato Dolphin3 per scrivere email, analizzare dati e risolvere problemi mentre ero completamente offline, cosa impossibile con le alternative basate sul cloud.
Utilizzo ancora l'intelligenza artificiale basata sul cloud.
Non posso fare a meno completamente dell'intelligenza artificiale basata sul cloud, e non era questo l'obiettivo iniziale. La verità è che per gestire modelli davvero potenti è necessaria l'intelligenza artificiale basata sul cloud, ed è la scelta perfetta. Personalmente, mi piace usare Perplexity per la ricerca e le attività basate sul web, dove ho bisogno di informazioni aggiornate e di ampi database di conoscenze. Questi servizi eccellono in attività che richiedono ingenti risorse di calcolo, dati in tempo reale o la formazione più aggiornata.
La cosa più importante è trovare il giusto equilibrio tra intelligenza artificiale cloud e intelligenza artificiale offline per garantire la massima privacy e sicurezza e ridurre al minimo la dipendenza dall'infrastruttura. Utilizzo i servizi cloud quando ho bisogno di funzionalità avanzate, integrazione con la ricerca web o quando non sono coinvolte informazioni sensibili. Per tutto il resto, in particolare per le conversazioni che coinvolgono dati personali o proprietari, o per le situazioni in cui ho bisogno di una disponibilità garantita, la mia configurazione on-premise prende il sopravvento.